Context Engineering คืออะไร? ออกแบบบริบทให้ AI องค์กรแม่นยำ
 ฟลุ้ค (นักศึกษา)
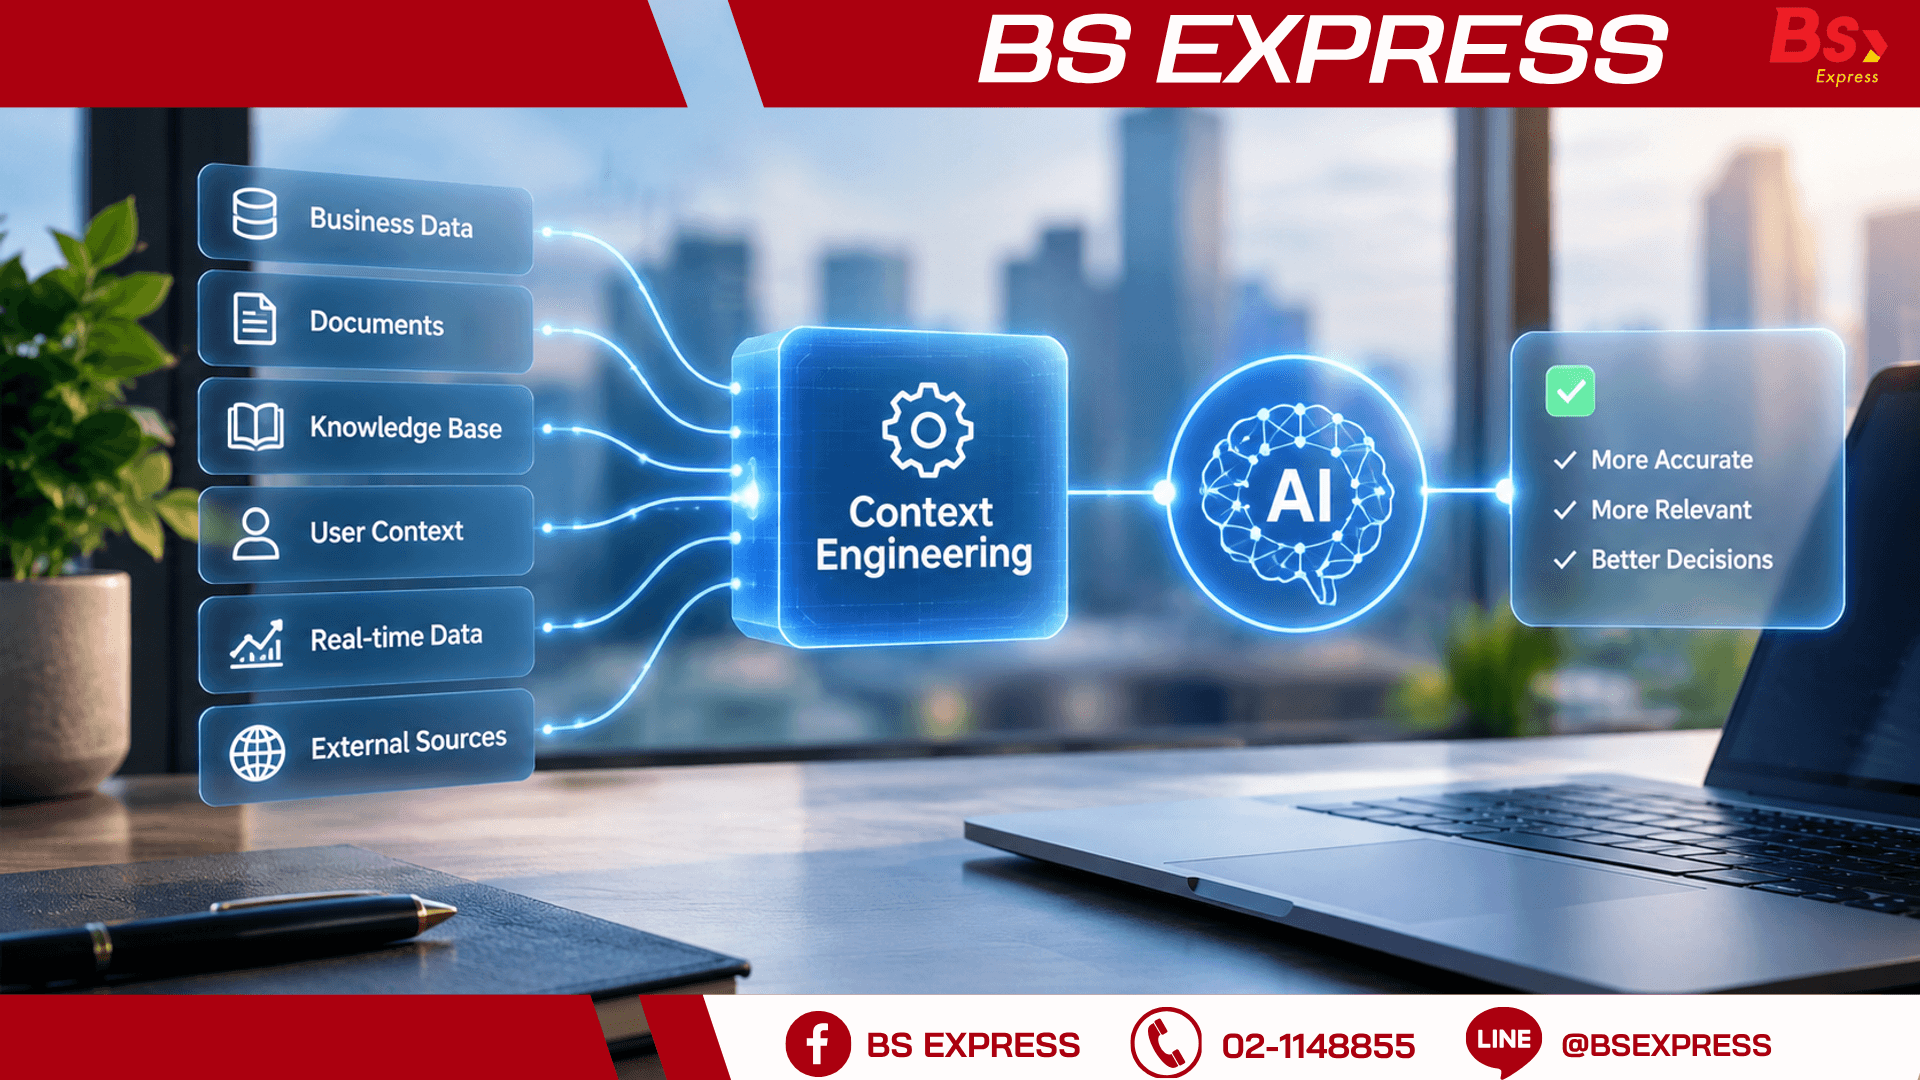
Context Engineering คืออะไร? ออกแบบบริบทให้ AI องค์กรแม่นยำ
ในช่วงสองปีที่ผ่านมา องค์กรจำนวนมากลงทุนกับ AI ไปแล้วอย่างน้อยหนึ่งรอบ และหลายแห่งพบปัญหาเดียวกัน นั่นคือระบบที่สาธิตได้สวยงามในห้องประชุม กลับตอบผิดพลาดเมื่อเจอคำถามจริงจากหน้างาน ทีมงานมักสรุปว่าเป็นเพราะ "โมเดลยังไม่เก่งพอ" แล้วรอรุ่นถัดไป หรือไม่ก็ทุ่มเวลาไปกับการขัดเกลาคำสั่ง (Prompt) ให้สละสลวยขึ้น แต่ผลลัพธ์ก็ยังไม่ดีขึ้นอย่างมีนัยสำคัญ
สาเหตุที่แท้จริงมักไม่ได้อยู่ที่โมเดลหรือถ้อยคำในคำสั่ง แต่อยู่ที่ "บริบท" ที่ป้อนเข้าไปให้โมเดลใช้คิด ไม่ว่าจะเป็นข้อมูลที่ขาดหาย ข้อมูลที่มากเกินจนกลบสาระสำคัญ หรือข้อมูลที่ขัดแย้งกันเองจากหลายระบบ แนวคิดที่เข้ามาตอบโจทย์นี้และกลายเป็นทักษะหลักของทีม AI องค์กรในปี 2026 เรียกว่า Context Engineering
Prompt Engineering ไม่ผิด แต่ไม่พออีกต่อไป
Prompt Engineering คือการออกแบบ "วิธีถาม" ให้โมเดลเข้าใจเจตนาของเรา ซึ่งยังจำเป็นอยู่ แต่มันตอบโจทย์เฉพาะงานที่ความรู้ทั้งหมดอยู่ในตัวโมเดลอยู่แล้ว เช่น การสรุปความ การแปล หรือการเขียนร่างอีเมล
ปัญหาคืองานที่สร้างมูลค่าทางธุรกิจจริงมักไม่ใช่แบบนั้น คำถามอย่าง "ตู้สินค้าล็อตนี้ควรเปลี่ยนเส้นทางหรือไม่" หรือ "ลูกค้ารายนี้มีสิทธิ์ได้เครดิตเทอมกี่วัน" ต้องการข้อมูลเฉพาะขององค์กร ณ เวลานั้น ซึ่งไม่มีทางอยู่ในข้อมูลฝึกของโมเดล ต่อให้เขียนคำสั่งดีเพียงใด โมเดลก็ตอบไม่ได้ หรือแย่กว่านั้นคือเดาแล้วตอบอย่างมั่นใจ
Context Engineering จึงขยับโฟกัสจาก "จะถามอย่างไร" ไปสู่ "จะจัดชุดข้อมูลอะไร ในรูปแบบไหน และเรียงลำดับอย่างไร ให้เข้าไปอยู่ในหน้าต่างบริบทของโมเดล ณ ขณะที่มันต้องตัดสินใจ"
นิยามและขอบเขตของ Context Engineering
Context Engineering คือการออกแบบและจัดการอย่างเป็นระบบว่า ในแต่ละครั้งที่เรียกใช้โมเดล จะมีข้อมูลชุดใดบ้างปรากฏอยู่ใน Context Window ซึ่งเป็นพื้นที่ความจำระยะสั้นที่โมเดลมองเห็นได้ทั้งหมดในการประมวลผลรอบนั้น
มองในเชิงวิศวกรรม งานนี้ไม่ต่างจากการออกแบบระบบข้อมูลทั่วไป คือต้องตอบว่าข้อมูลมาจากไหน ใครมีสิทธิ์เห็น ข้อมูลสดแค่ไหน และจะบีบอัดอย่างไรเมื่อพื้นที่จำกัด ความแตกต่างคือ "ผู้ใช้ปลายทาง" ไม่ใช่มนุษย์หรือรายงาน แต่เป็นโมเดลภาษาที่มีเพดานความสนใจจำกัด
องค์ประกอบของบริบทที่ต้องออกแบบมักแบ่งได้เป็นสี่ชั้น
คำสั่งระบบและกติกา :
ระบุบทบาท ขอบเขตอำนาจ น้ำเสียง และสิ่งที่ห้ามทำ เช่น ห้ามให้ส่วนลดเกินเพดาน หรือห้ามยืนยันวันส่งมอบโดยไม่อ้างอิงระบบจริง
ความรู้ที่ดึงมาเฉพาะกิจ :
เอกสารนโยบาย สัญญา คู่มือปฏิบัติงาน หรือข้อมูลธุรกรรมที่เกี่ยวข้องกับคำถามนั้นโดยตรง ดึงมาเท่าที่จำเป็น ไม่ใช่ยัดคู่มือทั้งเล่ม
เครื่องมือและผลลัพธ์จากเครื่องมือ :
คำอธิบายว่ามีฟังก์ชันใดเรียกใช้ได้บ้าง พร้อมผลลัพธ์ที่ได้กลับมา เช่น สถานะสต็อกตามเวลาจริง หรืออัตราค่าระวางล่าสุด
หน่วยความจำของบทสนทนา :
สิ่งที่คุยกันไปแล้วในรอบก่อนหน้า รวมถึงข้อเท็จจริงถาวรเกี่ยวกับผู้ใช้หรือลูกค้ารายนั้น
ศัตรูตัวจริงคือบริบทที่มากเกินไป
ความเข้าใจผิดที่พบบ่อยคือ เมื่อโมเดลรุ่นใหม่รองรับบริบทได้หลักแสนถึงหลักล้านโทเคน ก็ควรใส่ข้อมูลให้มากที่สุดเท่าที่ใส่ได้ ความจริงกลับตรงกันข้าม
การทดสอบจำนวนมากชี้ว่าคุณภาพการให้เหตุผลของโมเดลลดลงเมื่อบริบทยาวขึ้น แม้ข้อมูลที่ถูกต้องจะอยู่ในนั้นก็ตาม ปรากฏการณ์นี้ถูกเรียกกันว่า Context Rot โดยข้อมูลที่อยู่กลางบริบทยาวๆ มักถูกให้น้ำหนักน้อยกว่าข้อมูลต้นและท้าย และเมื่อมีเอกสารหลายฉบับที่เนื้อหาขัดแย้งกัน โมเดลอาจหยิบฉบับที่ล้าสมัยมาตอบ
ยังมีต้นทุนอีกสองด้านที่ผู้บริหารต้องชั่งน้ำหนัก ด้านแรกคือค่าใช้จ่ายต่อการเรียกใช้ที่แปรผันตรงกับจำนวนโทเคน ด้านที่สองคือเวลาตอบสนอง บริบทที่บวมเกินจำเป็นทำให้ระบบช้าลงจนผู้ใช้หน้างานเลิกใช้ ซึ่งเป็นสาเหตุการตายเงียบของโครงการ AI จำนวนไม่น้อย
หลักการที่ทีมที่ทำสำเร็จยึดถือจึงเป็น "ชุดโทเคนที่น้อยที่สุดที่ให้ผลลัพธ์ถูกต้องสูงสุด" ไม่ใช่การเติมให้เต็มพื้นที่
เทคนิคหลักที่ใช้ได้จริงในระดับองค์กร
การดึงข้อมูลแบบมีลำดับชั้น :
แทนที่จะค้นทุกอย่างพร้อมกัน ให้กรองด้วยเงื่อนไขเชิงโครงสร้างก่อน เช่น จำกัดเฉพาะสัญญาที่ยังมีผล เฉพาะประเทศ เฉพาะกลุ่มสินค้า แล้วจึงค้นเชิงความหมายภายในชุดที่แคบลง วิธีนี้ลดทั้งสัญญาณรบกวนและต้นทุน
การบีบอัดและสรุปย่อระหว่างทาง :
เมื่อบทสนทนาหรือกระบวนการทำงานยาวขึ้น ให้สรุปสิ่งที่เกิดขึ้นแล้วเป็นบันทึกสั้นๆ พร้อมคงไว้เฉพาะข้อเท็จจริงที่ยังต้องใช้ แล้วตัดรายละเอียดดิบทิ้ง เทคนิคนี้จำเป็นมากกับงานที่ต้องทำหลายขั้นตอนต่อเนื่อง
การแยกงานให้ตัวช่วยย่อย :
มอบงานค้นหาหรือวิเคราะห์เฉพาะส่วนให้กระบวนการย่อยที่มีบริบทของตัวเอง แล้วส่งกลับมาเฉพาะข้อสรุป วิธีนี้ทำให้บริบทหลักสะอาด และแก้ปัญหาเฉพาะจุดได้ง่ายเมื่อผลลัพธ์ผิดพลาด
การออกแบบคำอธิบายเครื่องมือ :
คำอธิบายฟังก์ชันที่คลุมเครือหรือทับซ้อนกันเป็นสาเหตุอันดับต้นๆ ที่ทำให้ระบบเรียกใช้เครื่องมือผิดตัว ควรตั้งชื่อให้ชัด แยกขอบเขตไม่ให้ซ้อนทับ และจำกัดจำนวนเครื่องมือที่เปิดให้เห็นในแต่ละงาน
การจัดการหน่วยความจำอย่างมีนโยบาย :
ต้องกำหนดชัดว่าอะไรควรจำข้ามครั้ง อะไรควรลืม และข้อมูลส่วนบุคคลใดที่ห้ามเก็บ ประเด็นนี้เชื่อมตรงกับข้อกำหนดด้านการคุ้มครองข้อมูลส่วนบุคคล จึงควรให้ฝ่ายกฎหมายร่วมออกแบบตั้งแต่ต้น
การประยุกต์ใช้ในธุรกิจและโลจิสติกส์
ในงานบริการลูกค้าของผู้ให้บริการขนส่ง บริบทที่ถูกต้องหมายถึงการรวมสถานะพัสดุตามเวลาจริง เงื่อนไขในสัญญาระดับบริการของลูกค้ารายนั้น และประวัติการร้องเรียนล่าสุด เข้าไว้ด้วยกัน ระบบที่เห็นเพียงสถานะพัสดุจะตอบถูกในเชิงข้อเท็จจริงแต่ผิดในเชิงพาณิชย์ เพราะไม่รู้ว่าลูกค้ารายนี้มีข้อตกลงชดเชยแบบใด
ในงานจัดซื้อและวางแผน บริบทที่ดีคือการนำนโยบายภายใน ข้อจำกัดของผู้ผลิต และข้อมูลต้นทุนล่าสุดมาไว้ในชุดเดียวกัน เพื่อให้ข้อเสนอแนะอยู่ในกรอบที่ปฏิบัติได้จริง ไม่ใช่คำแนะนำสวยหรูที่ฝ่ายปฏิบัติการทำตามไม่ได้
ในงานเอกสารการค้าและการปฏิบัติตามกฎระเบียบ ความแม่นยำขึ้นกับการอ้างอิงฉบับที่ถูกต้องเป็นสำคัญ ระบบที่ออกแบบบริบทดีจะระบุเสมอว่าใช้เอกสารฉบับใด วันที่เท่าใด ทำให้ผู้ใช้ตรวจสอบย้อนกลับได้ ซึ่งเป็นเงื่อนไขขั้นต่ำของการนำไปใช้ในกระบวนการที่มีความเสี่ยงสูง
แนวทางเริ่มต้นสำหรับองค์กร
ขั้นแรก เลือกกระบวนการเดียวที่มีปริมาณงานสูงและวัดผลได้ชัด แล้วทำ "การตรวจสอบบริบท" ว่าเพื่อตอบคำถามนี้ให้ถูกต้อง มนุษย์ผู้เชี่ยวชาญต้องเปิดดูข้อมูลจากที่ใดบ้าง คำตอบนั้นคือพิมพ์เขียวของบริบทที่ระบบต้องได้รับ
ขั้นที่สอง จัดระเบียบแหล่งข้อมูลให้พร้อมใช้ ทั้งการกำหนดว่าฉบับใดเป็นฉบับจริง การติดป้ายกำกับวันที่และสิทธิ์การเข้าถึง และการตัดเอกสารซ้ำซ้อนออก งานนี้ไม่หวือหวาแต่เป็นตัวชี้ขาดผลลัพธ์มากกว่าการเลือกโมเดล
ขั้นที่สาม สร้างชุดทดสอบจากคำถามจริงที่หน้างานเคยเจอ พร้อมคำตอบที่ถูกต้องซึ่งผู้เชี่ยวชาญยืนยันแล้ว เพื่อให้ทุกการปรับเปลี่ยนบริบทวัดผลได้ว่าดีขึ้นหรือแย่ลง ไม่ใช่ตัดสินด้วยความรู้สึก
ขั้นที่สี่ ติดตามตัวชี้วัดที่สะท้อนทั้งคุณภาพและต้นทุน ได้แก่ อัตราคำตอบที่ถูกต้องและอ้างอิงแหล่งที่มาได้ จำนวนโทเคนเฉลี่ยต่อหนึ่งงาน เวลาตอบสนอง และสัดส่วนที่ต้องส่งต่อให้มนุษย์ เมื่อคุณภาพคงที่แต่จำนวนโทเคนลดลง แปลว่าการออกแบบบริบทกำลังไปถูกทาง
ข้อควรระวัง
ความเสี่ยงที่ถูกมองข้ามคือช่องโหว่ด้านสิทธิ์การเข้าถึง หากกลไกดึงข้อมูลไม่บังคับสิทธิ์ในระดับเดียวกับระบบต้นทาง ผู้ใช้อาจได้เห็นข้อมูลที่ไม่ควรเห็นผ่านคำตอบของ AI อีกความเสี่ยงคือเนื้อหาจากภายนอกที่แฝงคำสั่งซ่อนไว้ ซึ่งอาจทำให้ระบบทำงานผิดเจตนา องค์กรจึงควรแยกให้ชัดระหว่างข้อมูลที่เชื่อถือได้กับข้อมูลที่รับมาจากภายนอก และไม่ให้สิทธิ์ดำเนินการสำคัญโดยอัตโนมัติจากข้อมูลกลุ่มหลัง
สรุป
Context Engineering คือการเปลี่ยนโจทย์จากการหาคำสั่งที่ดีที่สุด ไปสู่การออกแบบว่าข้อมูลใดควรปรากฏต่อหน้าโมเดลในจังหวะที่มันต้องตัดสินใจ ซึ่งเป็นงานที่ผสมระหว่างวิศวกรรมข้อมูล ความรู้เชิงกระบวนการ และการกำกับดูแล
สำหรับองค์กรที่เคยลงทุนกับ AI แล้วไม่ได้ผลตามคาด นี่มักเป็นจุดที่ควรกลับไปทบทวนก่อนเปลี่ยนโมเดลหรือเพิ่มงบประมาณ เพราะในทางปฏิบัติ ความได้เปรียบระยะยาวไม่ได้มาจากการเข้าถึงโมเดลที่เก่งที่สุด ซึ่งทุกคนเข้าถึงได้เท่ากัน แต่มาจากความสามารถในการจัดระเบียบและส่งมอบบริบทเฉพาะขององค์กรได้ดีกว่าคู่แข่ง