Federated Learning คืออะไร? ฝึก AI ร่วมกันโดยไม่แชร์ข้อมูล
 ฟลุ้ค (นักศึกษา)
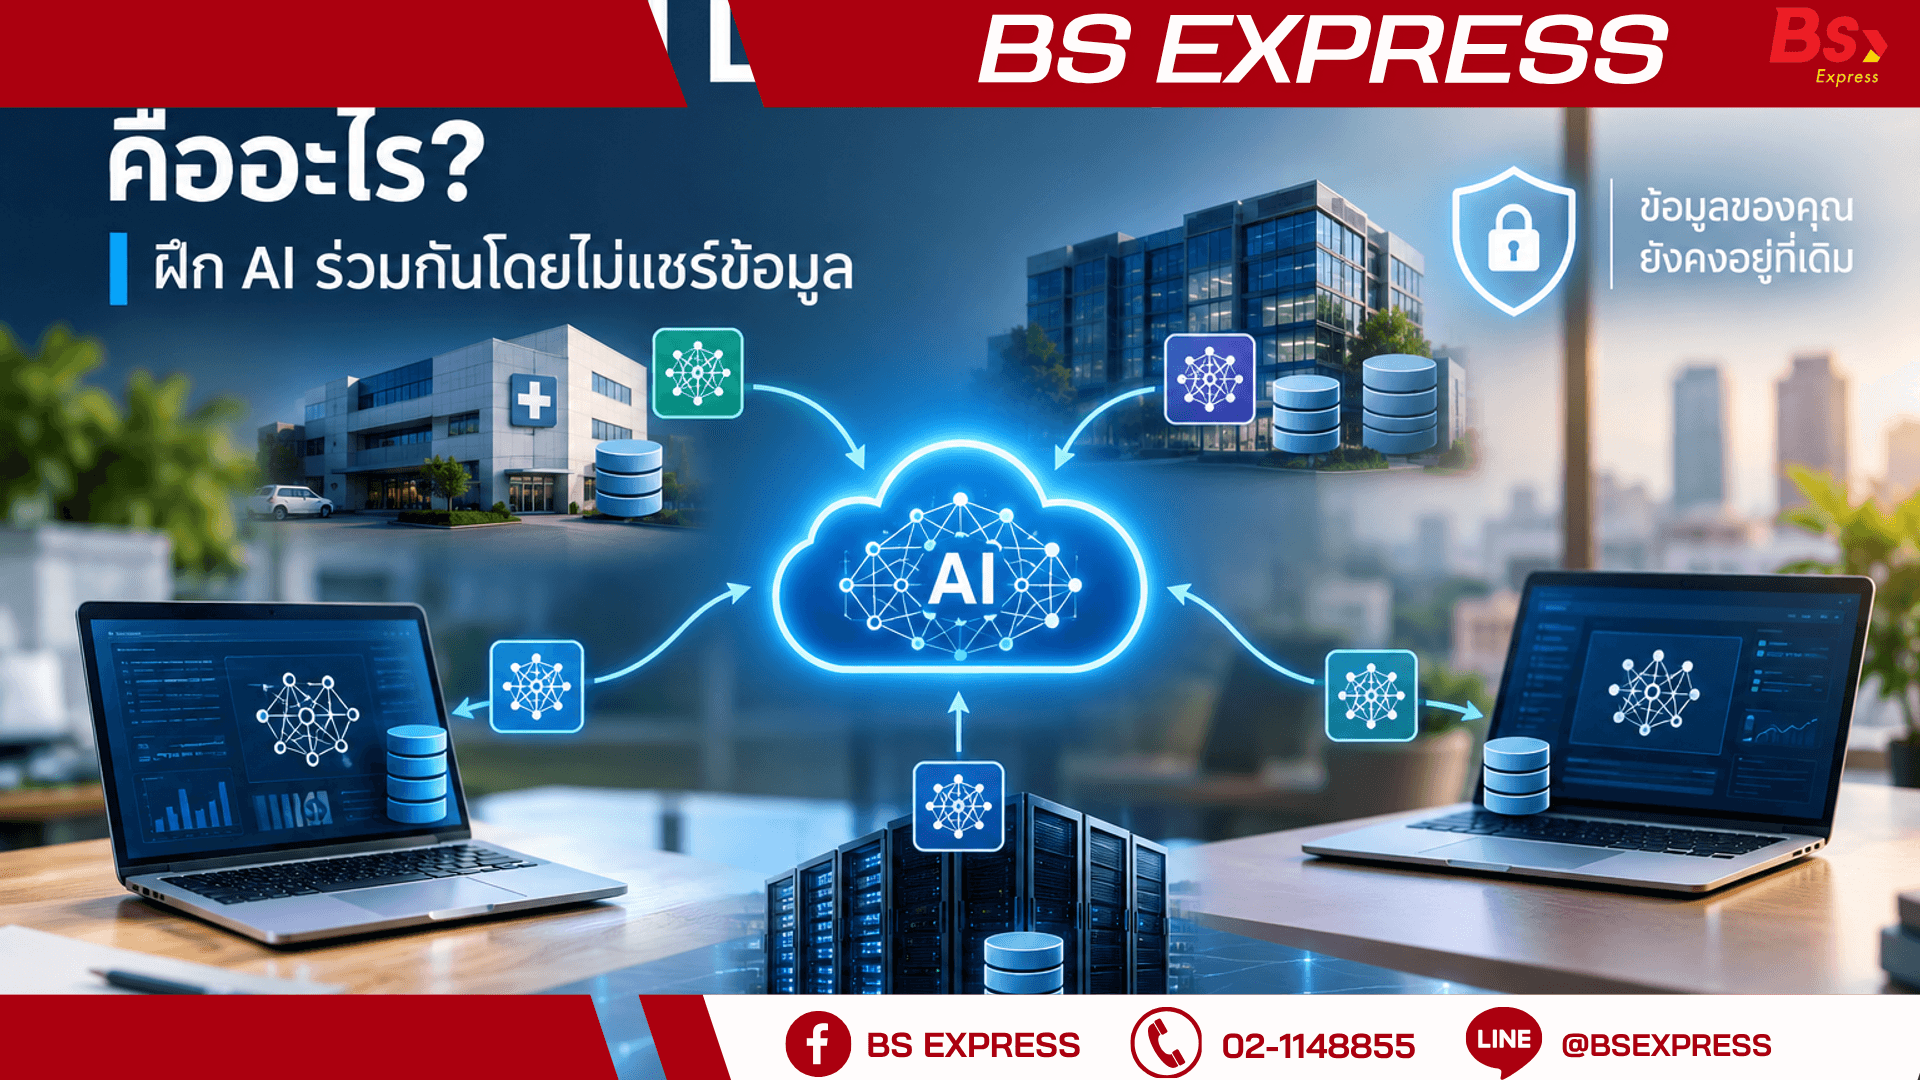
Federated Learning คืออะไร? ฝึก AI ร่วมกันโดยไม่แชร์ข้อมูล
โมเดล AI ที่แม่นยำต้องอาศัยข้อมูลจำนวนมากและหลากหลาย แต่ในโลกธุรกิจจริง ข้อมูลที่มีค่าที่สุดมักกระจายอยู่ในมือของหลายองค์กร เช่น ผู้ผลิต ผู้ขนส่ง ท่าเรือ ร้านค้าปลีก และสถาบันการเงิน แต่ละฝ่ายมีเหตุผลที่ไม่อยากส่งข้อมูลดิบให้ใคร ทั้งความลับทางการค้า ความเสี่ยงด้านความปลอดภัย ข้อกำหนดทางกฎหมาย และความไม่ไว้วางใจระหว่างคู่แข่งในอุตสาหกรรมเดียวกัน
Federated Learning หรือการเรียนรู้แบบกระจาย เป็นแนวทางที่พลิกวิธีคิดแบบเดิม จากที่ต้อง "เอาข้อมูลมารวมกันเพื่อฝึกโมเดล" มาเป็น "ส่งโมเดลไปหาข้อมูล" แล้วรวมเฉพาะสิ่งที่โมเดลเรียนรู้กลับมา บทความนี้อธิบายหลักการ รูปแบบ การนำไปใช้ในธุรกิจและโลจิสติกส์ รวมถึงข้อควรระวังที่ผู้บริหารต้องรู้ก่อนลงทุน
Federated Learning คืออะไร
Federated Learning คือเทคนิคการฝึกโมเดล Machine Learning ที่ข้อมูลฝึกยังคงอยู่ในที่เก็บเดิมของแต่ละองค์กรหรืออุปกรณ์ ไม่ถูกส่งไปรวมไว้ที่ศูนย์กลาง สิ่งที่ถูกแลกเปลี่ยนคือพารามิเตอร์หรือการอัปเดตของโมเดล (model updates) เท่านั้น
แนวคิดนี้ได้รับความนิยมอย่างกว้างขวางหลังจากนักวิจัยของ Google เผยแพร่งานวิจัยเมื่อราวปี 2016 และนำมาใช้จริงกับระบบคีย์บอร์ดทำนายคำบนสมาร์ทโฟน ที่โมเดลเรียนรู้จากพฤติกรรมการพิมพ์โดยไม่ต้องส่งข้อความของผู้ใช้ขึ้นเซิร์ฟเวอร์ ปัจจุบันแนวคิดเดียวกันถูกขยายไปสู่ภาคการแพทย์ การเงิน และอุตสาหกรรมที่ข้อมูลมีความอ่อนไหวสูง
หลักการทำงานแบบเข้าใจง่าย
กระบวนการพื้นฐานวนซ้ำเป็นรอบๆ ดังนี้
ขั้นที่ 1 แจกจ่ายโมเดลกลาง:
เซิร์ฟเวอร์กลาง (หรือผู้ประสานงาน) ส่งโมเดลเริ่มต้นไปยังผู้เข้าร่วมแต่ละราย เช่น บริษัท A, B และ C
ขั้นที่ 2 ฝึกในพื้นที่ของตนเอง:
แต่ละรายนำโมเดลไปฝึกกับข้อมูลภายในของตนเอง ข้อมูลไม่ออกจากระบบขององค์กร
ขั้นที่ 3 ส่งเฉพาะผลการเรียนรู้กลับ:
ผู้เข้าร่วมส่งการอัปเดตของโมเดล (เช่น น้ำหนักหรือค่า gradient) กลับมา แทนข้อมูลดิบ
ขั้นที่ 4 รวมผลและสร้างโมเดลรุ่นใหม่:
เซิร์ฟเวอร์รวมการอัปเดตจากทุกฝ่าย อัลกอริทึมพื้นฐานที่นิยมคือ Federated Averaging (FedAvg) ซึ่งใช้การเฉลี่ยถ่วงน้ำหนักตามปริมาณข้อมูลของแต่ละราย จากนั้นส่งโมเดลรุ่นใหม่กลับไปเริ่มรอบถัดไป
ผลลัพธ์คือโมเดลที่ได้เรียนรู้จากความรู้ร่วมของทุกฝ่าย โดยไม่มีใครต้องเปิดเผยข้อมูลดิบให้ผู้อื่น
รูปแบบของ Federated Learning
การเลือกรูปแบบให้เหมาะกับบริบทเป็นขั้นตอนสำคัญ โดยทั่วไปแบ่งได้ดังนี้
Cross-Device:
ผู้เข้าร่วมเป็นอุปกรณ์จำนวนมาก เช่น สมาร์ทโฟนหรืออุปกรณ์ IoT หลักล้านเครื่อง แต่ละเครื่องมีข้อมูลน้อยและเชื่อมต่อไม่เสถียร
Cross-Silo:
ผู้เข้าร่วมเป็นองค์กรจำนวนน้อย เช่น 3-50 ราย แต่ละรายมีข้อมูลปริมาณมากและระบบพร้อมกว่า เหมาะกับการร่วมมือระหว่างบริษัทหรือสถาบัน และเป็นรูปแบบที่เกี่ยวข้องกับงาน B2B มากที่สุด
อีกมุมหนึ่งคือการแบ่งตามลักษณะข้อมูล ได้แก่ Horizontal Federated Learning ที่ผู้เข้าร่วมมีฟีเจอร์ชุดเดียวกันแต่เป็นคนละกลุ่มตัวอย่าง (เช่น ผู้ให้บริการขนส่งหลายรายที่เก็บข้อมูลเส้นทางแบบเดียวกัน) และ Vertical Federated Learning ที่ผู้เข้าร่วมมีข้อมูลของลูกค้ากลุ่มเดียวกันแต่คนละมิติ (เช่น ผู้ผลิตมีข้อมูลการสั่งซื้อ ส่วนผู้ขนส่งมีข้อมูลการส่งมอบ)
ทำไมธุรกิจและโลจิสติกส์ควรสนใจ
ห่วงโซ่อุปทานเป็นระบบที่ข้อมูลกระจัดกระจายโดยธรรมชาติ ไม่มีองค์กรใดเห็นภาพครบทั้งเครือข่าย การรวมข้อมูลมักติดอุปสรรคทั้งเชิงกฎหมายและเชิงความไว้วางใจ Federated Learning จึงเปิดทางให้เกิดความร่วมมือที่ก่อนหน้านี้ทำได้ยาก โดยมีตัวอย่างการประยุกต์ใช้ที่น่าสนใจ ดังนี้
พยากรณ์เวลาถึง (ETA) ที่แม่นยำขึ้น:
ผู้ขนส่งหลายรายร่วมฝึกโมเดลเรียนรู้รูปแบบความล่าช้าบนเส้นทางและจุดคอขวดต่างๆ โดยไม่ต้องเปิดเผยข้อมูลลูกค้าหรือราคาขนส่งของตน
ตรวจจับการทุจริตและความผิดปกติ:
สถาบันการเงินและผู้ให้บริการด้านการค้าระหว่างประเทศเรียนรู้รูปแบบเอกสารหรือธุรกรรมที่น่าสงสัยร่วมกัน โดยไม่แลกเปลี่ยนข้อมูลลูกค้า
พยากรณ์ความต้องการข้ามห่วงโซ่:
ผู้ผลิต ผู้จัดจำหน่าย และร้านค้าปลีกสามารถสร้างโมเดลที่เห็นสัญญาณความต้องการจากหลายจุด โดยไม่เปิดเผยข้อมูลยอดขายรายสินค้าให้กัน
โมเดลบนอุปกรณ์ปลายทาง:
ยานพาหนะ เซนเซอร์ และอุปกรณ์ในคลังสินค้าช่วยกันปรับปรุงโมเดลตรวจจับความผิดปกติ โดยข้อมูลดิบไม่ต้องส่งขึ้นคลาวด์ทั้งหมด ลดทั้งภาระแบนด์วิดท์และความเสี่ยงด้านความเป็นส่วนตัว
สุขภาพและเภสัชกรรม:
โรงพยาบาลและบริษัทยาร่วมฝึกโมเดลวิเคราะห์ภาพทางการแพทย์หรือประสิทธิภาพการรักษา ซึ่งเป็นหนึ่งในสาขาที่มีงานวิจัยและการใช้งานจริงมากที่สุดของเทคโนโลยีนี้
ความเชื่อมโยงกับ PDPA และการกำกับดูแลข้อมูล
ในประเทศไทย พ.ร.บ.คุ้มครองข้อมูลส่วนบุคคล (PDPA) กำหนดหน้าที่ให้องค์กรต้องจำกัดการเก็บ ใช้ และเปิดเผยข้อมูลส่วนบุคคลเท่าที่จำเป็น การที่ข้อมูลไม่ต้องถูกโอนออกจากต้นทางช่วยลดความเสี่ยงด้านการส่งต่อข้อมูลและการรั่วไหลได้อย่างมีนัยสำคัญ และสอดรับกับหลักการลดข้อมูลให้เหลือน้อยที่สุด (data minimization)
อย่างไรก็ตาม ต้องเข้าใจให้ถูกต้องว่า Federated Learning ไม่ได้ทำให้ปัญหาด้านกฎหมายหายไปโดยอัตโนมัติ การอัปเดตของโมเดลอาจยังมีร่องรอยของข้อมูลต้นทางหลงเหลืออยู่ จึงควรให้ฝ่ายกฎหมายและผู้ดูแลข้อมูลส่วนบุคคลประเมินร่วมกันเสมอ และกำหนดข้อตกลงระหว่างผู้เข้าร่วมให้ชัดเจน เช่น ใครเป็นเจ้าของโมเดลที่ได้ ใครมีสิทธิ์ใช้ประโยชน์ และจะจัดการอย่างไรหากมีผู้ถอนตัว
เทคนิคเสริมความเป็นส่วนตัวที่มักใช้ควบคู่กัน
งานวิจัยชี้ว่า การส่งเฉพาะการอัปเดตของโมเดลยังมีความเสี่ยงที่ผู้ไม่หวังดีอาจพยายามย้อนรอยเพื่อสืบข้อมูลต้นทางได้ (inference attack) ระบบที่ใช้งานจริงจึงมักผสมเทคนิคต่อไปนี้
Differential Privacy:
เพิ่มสัญญาณรบกวนทางสถิติในการอัปเดตอย่างมีการคำนวณ เพื่อให้ไม่สามารถระบุได้ว่าข้อมูลของบุคคลใดบุคคลหนึ่งอยู่ในชุดฝึกหรือไม่ แลกกับความแม่นยำที่อาจลดลงเล็กน้อย
Secure Aggregation:
ใช้การเข้ารหัสทางคริปโตกราฟีเพื่อให้เซิร์ฟเวอร์เห็นเพียงผลรวมของการอัปเดตจากทุกฝ่าย ไม่เห็นการอัปเดตรายบริษัท
Homomorphic Encryption และ Trusted Execution Environment:
ประมวลผลบนข้อมูลที่เข้ารหัส หรือภายในพื้นที่ฮาร์ดแวร์ที่แยกและตรวจสอบได้ ช่วยเพิ่มระดับความปลอดภัยแต่มีต้นทุนด้านประสิทธิภาพ
ความท้าทายที่ต้องเตรียมรับมือ
แม้แนวคิดจะน่าสนใจ แต่การนำไปใช้จริงมีอุปสรรคที่ไม่ควรมองข้าม
ข้อมูลไม่สม่ำเสมอ (Non-IID Data):
ข้อมูลของแต่ละองค์กรมีการกระจายตัวต่างกัน เช่น ผู้ขนส่งทางไกลกับผู้ขนส่งในเมืองมีรูปแบบต่างกันมาก ทำให้โมเดลรวมอาจลู่เข้าช้าหรือให้ผลไม่ดีกับบางราย
คุณภาพข้อมูลที่ตรวจสอบยาก:
เมื่อไม่เห็นข้อมูลของกันและกัน การตรวจสอบว่าผู้ร่วมรายใดส่งอัปเดตจากข้อมูลคุณภาพต่ำหรือถูกปนเปื้อนโดยเจตนา (model poisoning) ทำได้ยากกว่าเดิม
ต้นทุนการสื่อสารและระบบ:
การส่งอัปเดตหลายรอบมีภาระด้านเครือข่ายและต้องมีมาตรฐานระบบที่เข้ากันได้ระหว่างองค์กร
การกำกับดูแลและการแบ่งผลประโยชน์:
คำถามที่ยากที่สุดมักไม่ใช่เรื่องเทคนิค แต่เป็นเรื่องว่าใครได้ประโยชน์เท่าไร และจะป้องกันไม่ให้ผู้ร่วมรายหนึ่งได้เปรียบจากความรู้ของรายอื่นโดยไม่ได้ลงทุนเท่าเทียมกันได้อย่างไร
เครื่องมือและเฟรมเวิร์กที่นิยม
ปัจจุบันมีโอเพนซอร์สเฟรมเวิร์กให้ทดลองได้โดยไม่ต้องเริ่มจากศูนย์ เช่น Flower, NVIDIA FLARE, TensorFlow Federated, OpenFL และ PySyft โดยแต่ละตัวมีจุดแข็งต่างกัน บางตัวเน้นความง่ายในการทดลอง บางตัวเน้นการใช้งานระดับองค์กรและรองรับหลายเฟรมเวิร์ก ควรตรวจสอบความสามารถและสถานะการพัฒนาล่าสุดก่อนเลือกใช้เสมอ
เปรียบเทียบกับแนวทางแลกเปลี่ยนข้อมูลอื่น
Federated Learning ไม่ใช่คำตอบเดียวของการทำงานร่วมกันบนข้อมูล ทางเลือกอื่นเหมาะกับโจทย์ต่างกัน เช่น การรวมข้อมูลไว้ที่ศูนย์กลาง (centralized) ให้ความแม่นยำสูงสุดแต่ความเสี่ยงสูงสุด การใช้ข้อมูลสังเคราะห์ช่วยลดความอ่อนไหวของข้อมูล ส่วนการวิเคราะห์ร่วมกันในสภาพแวดล้อมที่ควบคุมก็เหมาะกับการหาข้อมูลเชิงลึกเฉพาะกิจ Federated Learning โดดเด่นเมื่อเป้าหมายคือการ "ฝึกโมเดลที่ใช้งานต่อเนื่อง" และข้อมูลไม่สามารถออกจากองค์กรได้จริงๆ
แนวทางเริ่มต้นสำหรับองค์กร
เพื่อไม่ให้โครงการกลายเป็นงานวิจัยที่ไม่ถึงปลายทาง ควรเริ่มอย่างเป็นขั้นตอน
1. เลือกโจทย์ที่ข้อมูลร่วมสร้างคุณค่าชัดเจน:
มองหาปัญหาที่ข้อมูลองค์กรเดียวไม่เพียงพอ และพันธมิตรมีแรงจูงใจร่วมกัน เช่น การพยากรณ์ความล่าช้าหรือการตรวจจับความผิดปกติ
2. ทดลองแบบ Cross-Silo ขนาดเล็ก:
เริ่มกับพันธมิตร 2-3 ราย ที่มีความไว้วางใจกันอยู่แล้ว และวัดผลเทียบกับโมเดลที่ฝึกจากข้อมูลของแต่ละรายเพียงลำพัง
3. วางข้อตกลงด้านกฎหมายและธรรมาภิบาลตั้งแต่ต้น:
กำหนดความเป็นเจ้าของโมเดล สิทธิ์การใช้งาน มาตรฐานความปลอดภัย และกลไกตรวจสอบ
4. เพิ่มเทคนิคปกป้องความเป็นส่วนตัวตามระดับความเสี่ยง:
ประเมินว่าจำเป็นต้องใช้ Differential Privacy หรือ Secure Aggregation หรือไม่ ตามความอ่อนไหวของข้อมูล
5. วัดผลเชิงธุรกิจ:
เทียบความแม่นยำที่ดีขึ้นกับต้นทุนระบบและค่าใช้จ่ายด้านการประสานงาน เพื่อตัดสินใจว่าจะขยายผลหรือไม่
สรุป
Federated Learning คือแนวทางที่ช่วยให้หลายองค์กรร่วมกันสร้างโมเดล AI ที่ฉลาดขึ้นโดยไม่ต้องแชร์ข้อมูลดิบ จึงเหมาะกับธุรกิจที่ข้อมูลกระจายอยู่หลายมือ มีความอ่อนไหว และต้องปฏิบัติตามกฎหมายคุ้มครองข้อมูลอย่าง PDPA ในภาคโลจิสติกส์และซัพพลายเชน เทคโนโลยีนี้เปิดโอกาสให้เกิดความร่วมมือที่ก่อนหน้านี้ติดขัดเพราะความไม่ไว้วางใจ
อย่างไรก็ตาม ความสำเร็จไม่ได้ขึ้นกับอัลกอริทึมเพียงอย่างเดียว แต่ขึ้นกับการออกแบบธรรมาภิบาล การเลือกเทคนิคปกป้องความเป็นส่วนตัวที่เหมาะสม และความชัดเจนเรื่องผลประโยชน์ร่วมของทุกฝ่าย องค์กรที่เริ่มทดลองกับพันธมิตรที่ไว้ใจได้ตั้งแต่วันนี้ จะได้เรียนรู้และสร้างความได้เปรียบเชิงข้อมูลที่คู่แข่งซึ่งยังพึ่งพาข้อมูลของตนเพียงลำพังตามได้ยาก