RAG ในองค์กร คืออะไร? ให้ AI ตอบจากข้อมูลบริษัทได้แม่นยำ
 ฟลุ้ค (นักศึกษา)
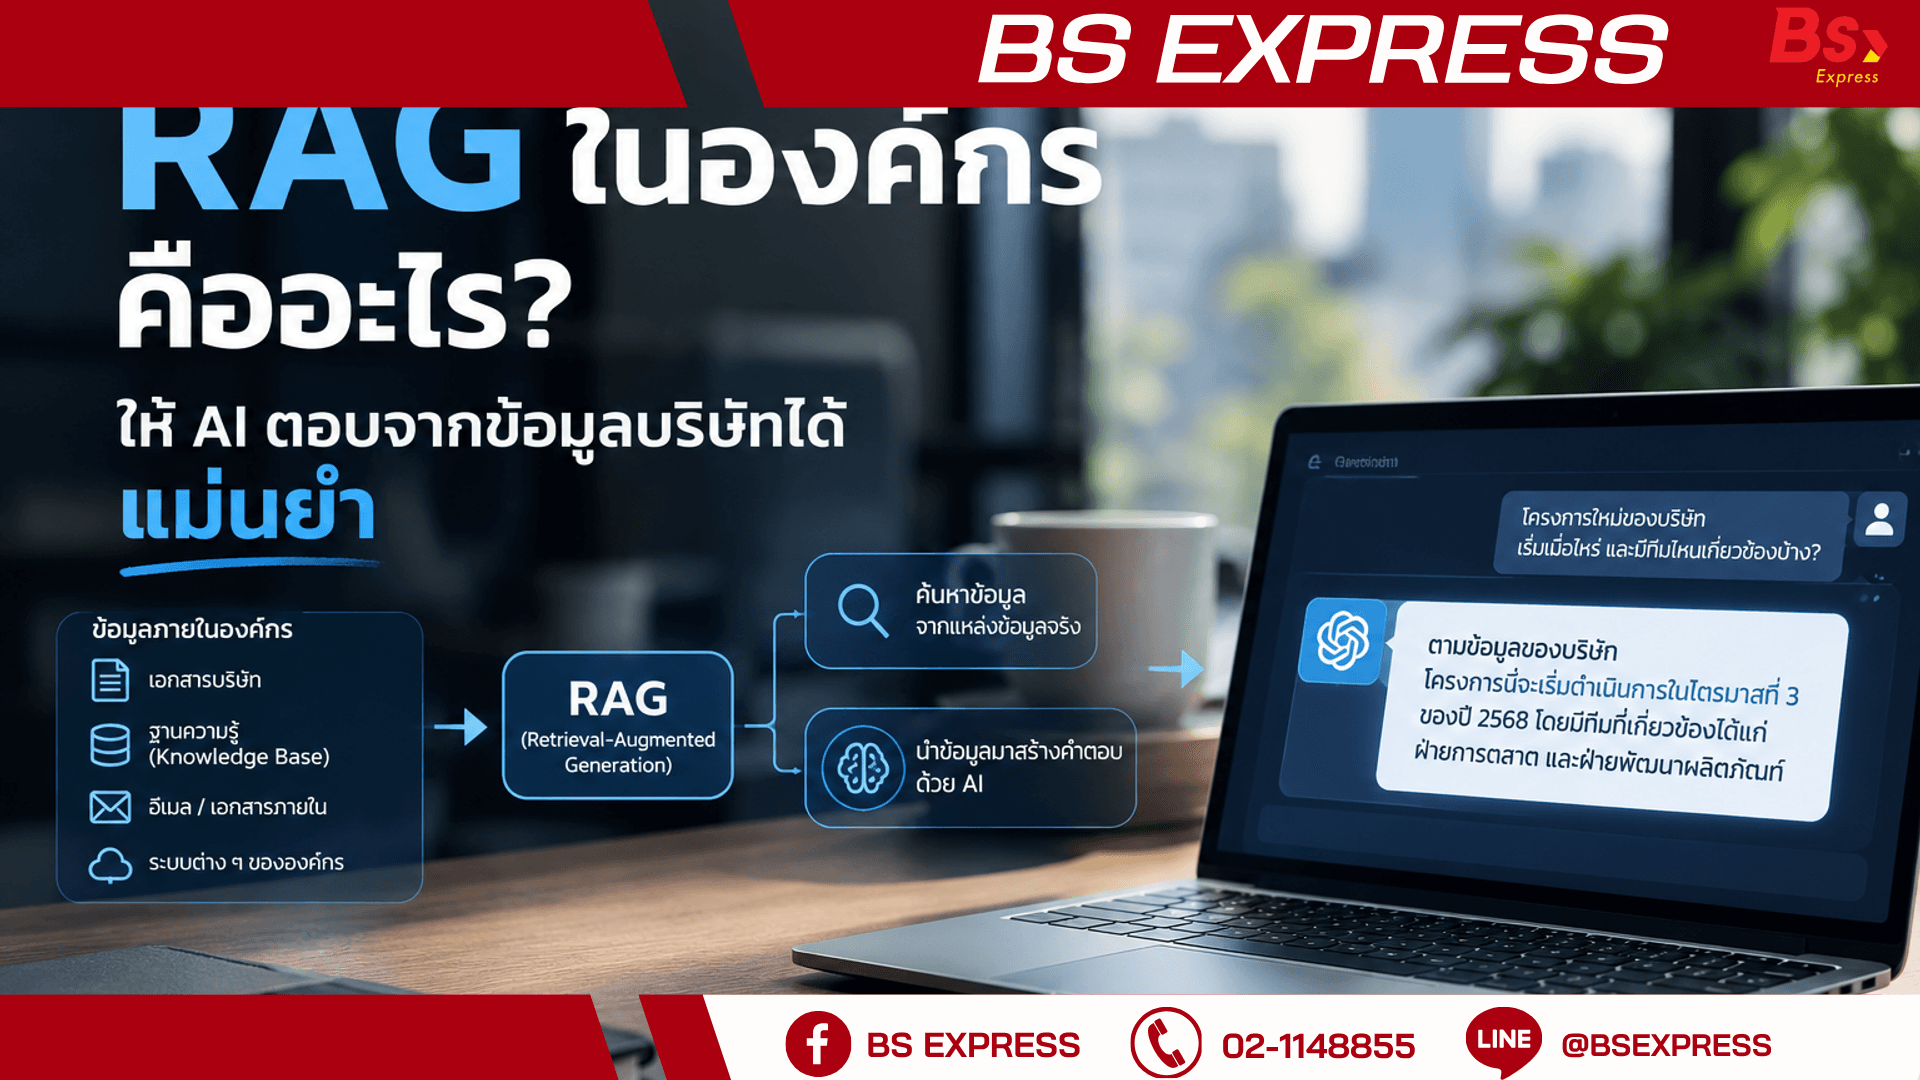
RAG ในองค์กร คืออะไร? ให้ AI ตอบจากข้อมูลบริษัทได้แม่นยำ
องค์กรจำนวนมากทดลองนำโมเดลภาษาขนาดใหญ่ (LLM) มาใช้ตอบคำถามพนักงานหรือลูกค้า แล้วพบปัญหาเดียวกัน คือโมเดลตอบได้คล่องแต่ไม่รู้จักข้อมูลภายในบริษัท เช่น ราคาขนส่งล่าสุด เงื่อนไขในสัญญา หรือขั้นตอนปฏิบัติงานที่เพิ่งปรับปรุง และบางครั้งก็ตอบด้วยความมั่นใจทั้งที่ข้อมูลไม่ถูกต้อง
RAG หรือ Retrieval-Augmented Generation คือแนวทางที่แก้ปัญหานี้ได้ตรงจุด โดยให้ระบบค้นเอกสารที่เกี่ยวข้องจากแหล่งข้อมูลขององค์กรก่อน แล้วส่งเนื้อหานั้นให้โมเดลใช้ประกอบการตอบ บทความนี้อธิบายหลักการ องค์ประกอบ กรณีใช้งาน และข้อควรระวังในการนำ RAG ไปใช้จริง
RAG คืออะไร
RAG เป็นสถาปัตยกรรมที่รวมสองส่วนเข้าด้วยกัน ส่วนแรกคือการค้นคืนข้อมูล (Retrieval) ที่ดึงเนื้อหาซึ่งเกี่ยวข้องกับคำถามออกมาจากฐานข้อมูลหรือเอกสาร ส่วนที่สองคือการสร้างคำตอบ (Generation) ที่ให้ LLM เรียบเรียงคำตอบจากเนื้อหาที่ดึงมานั้น แนวคิดนี้ถูกนำเสนอในงานวิจัยของทีมนักวิจัยจาก Meta ราวปี 2020 และกลายเป็นรูปแบบมาตรฐานของ AI ระดับองค์กรในปัจจุบัน
เปรียบได้กับการสอบแบบเปิดตำรา โมเดลไม่จำเป็นต้องจำทุกอย่างไว้ในหัว แต่เปิดหาข้อมูลที่ถูกต้องก่อนตอบ ทำให้คำตอบอ้างอิงแหล่งที่มาได้และตรวจสอบย้อนกลับได้
ทำไมองค์กรจึงต้องใช้ RAG
ข้อมูลเป็นปัจจุบัน: ความรู้ของ LLM หยุดอยู่ ณ เวลาที่ฝึกโมเดล ส่วน RAG ดึงข้อมูลจากคลังเอกสารที่อัปเดตได้ตลอดเวลา โดยไม่ต้องฝึกโมเดลใหม่
ลดคำตอบที่ผิดพลาด: เมื่อบังคับให้โมเดลตอบจากเอกสารที่ดึงมา โอกาสเกิดอาการหลอน (Hallucination) จะลดลงอย่างมาก แต่ไม่ได้หมดไปโดยสิ้นเชิง
อ้างอิงแหล่งที่มาได้: ระบบแสดงได้ว่าคำตอบมาจากเอกสารฉบับใด หน้าใด ซึ่งสำคัญมากในงานที่ต้องตรวจสอบได้ เช่น กฎหมาย การเงิน และการปฏิบัติตามกฎระเบียบ
ควบคุมสิทธิ์การเข้าถึงได้: ข้อมูลยังอยู่ในระบบขององค์กร และกำหนดได้ว่าผู้ใช้แต่ละคนเห็นเอกสารใดได้บ้าง
คุ้มค่ากว่าการฝึกโมเดลเอง: การอัปเดตเอกสารในฐานความรู้ง่ายและถูกกว่าการปรับจูนโมเดลใหม่ทุกครั้งที่ข้อมูลเปลี่ยน
องค์ประกอบหลักของระบบ RAG
ระบบ RAG โดยทั่วไปทำงานเป็นสองช่วง คือช่วงเตรียมข้อมูล และช่วงตอบคำถาม
ช่วงเตรียมข้อมูล (Indexing):
เริ่มจากรวบรวมเอกสารจากแหล่งต่างๆ เช่น PDF คู่มือปฏิบัติงาน สัญญา อีเมล และระบบ ERP หรือ WMS จากนั้นแบ่งเอกสารเป็นชิ้นเล็กๆ (Chunking) แปลงแต่ละชิ้นเป็นเวกเตอร์ตัวเลขด้วยโมเดล Embedding ที่จับความหมายของข้อความ แล้วเก็บไว้ใน Vector Database พร้อม Metadata เช่น ชื่อเอกสาร วันที่ และระดับสิทธิ์
ช่วงตอบคำถาม (Query):
เมื่อผู้ใช้ถามคำถาม ระบบแปลงคำถามเป็นเวกเตอร์ ค้นหาชิ้นข้อมูลที่ใกล้เคียงความหมายที่สุด อาจจัดอันดับใหม่ด้วยโมเดล Reranker เพื่อคัดเฉพาะชิ้นที่ตรงจริงๆ แล้วส่งให้ LLM พร้อมคำสั่งให้ตอบจากข้อมูลนี้เท่านั้นและระบุแหล่งอ้างอิง
RAG กับ Fine-tuning ต่างกันอย่างไร
หลายองค์กรสับสนว่าควรเลือกแบบใด ความต่างที่สำคัญคือ Fine-tuning ปรับพฤติกรรมของโมเดล เช่น น้ำเสียง รูปแบบคำตอบ หรือทักษะเฉพาะทาง ส่วน RAG เพิ่ม "ความรู้" ให้โมเดลในขณะตอบ
หากต้องการให้ AI รู้ข้อมูลที่เปลี่ยนบ่อย และต้องอ้างอิงที่มาได้ RAG เหมาะกว่า หากต้องการให้โมเดลเขียนในรูปแบบเฉพาะหรือเข้าใจศัพท์เทคนิคเฉพาะทางมาก Fine-tuning ช่วยได้ ในทางปฏิบัติหลายองค์กรใช้ทั้งสองอย่างร่วมกัน โดยเริ่มจาก RAG ก่อนเพราะลงทุนน้อยกว่าและเห็นผลเร็วกว่า
กรณีใช้งานในธุรกิจและโลจิสติกส์
ผู้ช่วยตอบ SOP และคู่มือปฏิบัติงาน: พนักงานคลังสินค้าหรือศูนย์กระจายสินค้าถามขั้นตอนการรับสินค้า การจัดการสินค้าเสียหาย หรือมาตรฐานความปลอดภัย แล้วได้คำตอบพร้อมอ้างอิงเอกสารฉบับล่าสุด
ผู้ช่วยด้านศุลกากรและเอกสารนำเข้า-ส่งออก: ค้นพิกัดศุลกากร เงื่อนไขการนำเข้า และประกาศที่เกี่ยวข้อง แล้วสรุปให้ทีมปฏิบัติการ โดยมีผู้เชี่ยวชาญตรวจทานก่อนใช้งานจริง
การวิเคราะห์สัญญาและเงื่อนไขทางการค้า: ถามว่าสัญญากับผู้ให้บริการขนส่งรายหนึ่งกำหนดค่าปรับล่าช้าไว้อย่างไร แล้วให้ระบบชี้ข้อความที่เกี่ยวข้องออกมา
งานบริการลูกค้า: ตอบคำถามสถานะและนโยบายการจัดส่งจากฐานความรู้ ลดภาระทีมซัพพอร์ตและตอบได้สม่ำเสมอ
การจัดซื้อและการประเมินซัพพลายเออร์: สรุปข้อมูลจากรายงานตรวจประเมิน ใบเสนอราคา และประวัติการทำงานหลายฉบับให้อยู่ในคำตอบเดียว
ความท้าทายที่พบบ่อย
คุณภาพของข้อมูลต้นทาง: ระบบ RAG จะดีได้เท่าที่เอกสารดี หากมีเอกสารซ้ำ ขัดแย้งกัน หรือหมดอายุแล้ว คำตอบก็จะสับสนตามไปด้วย การกำหนดเจ้าของเอกสารและวงจรทบทวนจึงสำคัญไม่แพ้เทคโนโลยี
การแบ่งชิ้นข้อมูลไม่เหมาะสม: หากตัดเอกสารเล็กเกินไป บริบทจะขาด หากใหญ่เกินไปจะมีสิ่งไม่เกี่ยวข้องปนมา ควรทดลองปรับขนาดและการเหลื่อมกันของชิ้นข้อมูลตามชนิดเอกสาร
การค้นหาไม่ตรงคำถาม: การค้นด้วยความหมายอย่างเดียวอาจพลาดรหัสสินค้า เลขที่สัญญา หรือศัพท์เฉพาะ จึงนิยมใช้การค้นแบบผสม (Hybrid Search) ที่รวมการค้นด้วยคำหลักและด้วยความหมายเข้าด้วยกัน
ความปลอดภัยและสิทธิ์การเข้าถึง: ต้องกรองเอกสารตามสิทธิ์ของผู้ถามตั้งแต่ขั้นค้นหา ไม่ใช่กรองหลังจากโมเดลตอบแล้ว และควรป้องกันเอกสารที่แฝงคำสั่งอันตราย (Prompt Injection)
ตารางและเอกสารสแกน: ตารางราคาหรือเอกสารภาพสแกนมักอ่านผิดพลาด ต้องใช้เครื่องมือแยกโครงสร้างเอกสารที่เหมาะสม
วิธีวัดผลระบบ RAG
ไม่ควรประเมินด้วยความรู้สึกว่า "คำตอบดูดี" แต่ควรวัดแยกเป็นสองส่วน ส่วนการค้นคืน ดูว่าระบบดึงเอกสารที่ถูกต้องมาได้ครบและตรงหรือไม่ ส่วนการสร้างคำตอบ ดูว่าคำตอบยึดตามเอกสารที่ดึงมาจริงหรือเพิ่มข้อมูลเกินเอง และตอบตรงคำถามหรือไม่
แนวปฏิบัติที่ได้ผลคือสร้างชุดคำถามทดสอบจากงานจริง พร้อมคำตอบอ้างอิงที่ผู้เชี่ยวชาญยืนยันแล้ว รันทดสอบทุกครั้งที่เปลี่ยนโมเดล ปรับการแบ่งชิ้นข้อมูล หรืออัปเดตฐานความรู้ และติดตามคำถามที่ระบบตอบไม่ได้หรือผู้ใช้ให้คะแนนต่ำเพื่อนำมาปรับปรุงต่อเนื่อง
ขั้นตอนเริ่มต้นสำหรับองค์กร
1. เลือกกรณีใช้งานที่ขอบเขตชัด: เริ่มจากงานที่มีเอกสารเป็นระบบและมีคำถามซ้ำบ่อย เช่น คู่มือปฏิบัติงานของฝ่ายใดฝ่ายหนึ่ง แทนการสร้างระบบตอบทุกเรื่องทั้งบริษัท
2. จัดระเบียบแหล่งข้อมูล: คัดเอกสารฉบับล่าสุด ลบของซ้ำ และกำหนดเจ้าของข้อมูลพร้อม Metadata ที่จำเป็น
3. สร้างต้นแบบและชุดทดสอบ: ทำระบบเล็กๆ พร้อมชุดคำถามทดสอบจากงานจริง เพื่อวัดคุณภาพตั้งแต่ต้น
4. ออกแบบให้มีการตรวจสอบโดยคน: สำหรับงานเสี่ยงสูง เช่น สัญญาและกฎระเบียบ ให้แสดงแหล่งอ้างอิงและมีขั้นตอนยืนยันก่อนนำไปใช้
5. ขยายผลและเฝ้าติดตาม: เพิ่มแหล่งข้อมูลและผู้ใช้ทีละขั้น พร้อมติดตามคุณภาพ ต้นทุน และความปลอดภัยอย่างต่อเนื่อง
สรุป
RAG คือสะพานที่เชื่อมความสามารถด้านภาษาของ LLM เข้ากับความรู้เฉพาะขององค์กร ทำให้ AI ตอบได้ตรงกับข้อมูลจริง อัปเดตได้ง่าย และตรวจสอบย้อนกลับได้ จึงเป็นจุดเริ่มต้นที่เหมาะสำหรับองค์กรที่ต้องการใช้ Generative AI อย่างมีความรับผิดชอบ
อย่างไรก็ตาม ความสำเร็จไม่ได้ขึ้นกับโมเดลเพียงอย่างเดียว แต่ขึ้นกับคุณภาพข้อมูล การออกแบบการค้นหา การควบคุมสิทธิ์ และการวัดผลอย่างเป็นระบบ องค์กรที่เริ่มจากกรณีใช้งานที่ชัดเจน ลงทุนกับการจัดการเอกสาร และทดสอบด้วยคำถามจริง จะได้ระบบ RAG ที่ทีมงานไว้วางใจและใช้งานได้ในชีวิตประจำวัน